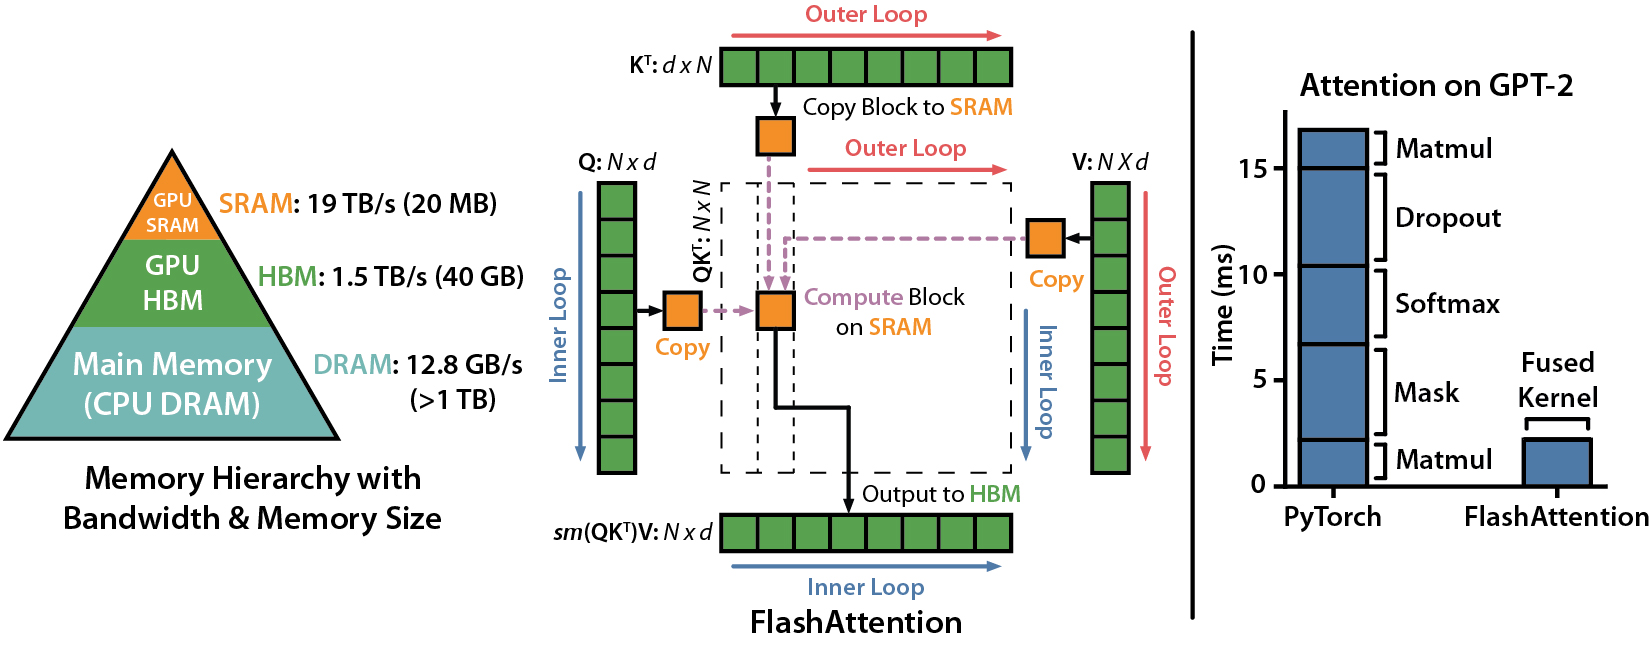
测试平台:RTX 5080
前言:按照论文中v2的思路实现一遍功能,加入v1中部分未使用的优化策略,调用cuda core计算。
1 v2思路分析
1.1 循环:Q 外层、K/V 内层
把内外层对调:外层遍历 Q 块,内层流式过所有 K/V 块。grid 变成:
grid  = (ceil(N/Br), B*H)    // x 是 Q 块编号,y 是 batch*head
block = Br 个线程            // 一线程一行
block 数从「恒等于 32」变成「随 N 增长」。N=8192、Br=128 时是 64×32 = 2048 个 block,84 个 SM 能分到很多个block排队。
对线程来说变化也大:v1 里一个线程在内层循环中要轮着伺候所有 Q 块;v2 里线程绑定一个 Q 行,Br=128 时 block 里有 4 个 warp,每个 warp 独占 32 行、互不通信,这就是 v2 论文「warp 沿 Q 维切分」的标量形态。
1.2 m/l/O 状态全程片上
循环换边之后,一个 block 只负责一个 Q 块,它的状态生命周期就是 kernel 本身:
- Q 只加载一次,驻留 shared 撑完整个内循环(官方注释 "stay in SRAM throughout")
- m/l 变成每线程 2 个标量寄存器,kernel 里初始化(-inf 和 0),不再有 HBM 数组
- O 变成 shared 里的未归一化累加器 Oacc,最后写回一次
O 的 HBM 往返从 2N²D/Bc 掉到 2ND——对 N=8192 来说是 64 倍的差距
1.3 延迟归一化:除法从 Tc×D 次变成 D 次
在此版本中矩阵乘调用的也是cuda core,下个版本优化将会重构代码调用wmma使用Tensor core进行矩阵运算,因此要尽量减少非矩阵乘的操作以加快运行速度。
v1 每轮合并都要 ÷ l_new,一轮 D 次除法,Tc 轮就是 Tc×D 次。v2 学官方实现的技巧:内循环里维护未归一化的累加器 Õ,更新只有乘加:
Õ = e^{m_old−m_new}·Õ + e^{m̃−m_new}·(P̃@V)     // 内循环,纯乘加
O = Õ / l                                       // 结束后除一次
1.4 causal mask优化
Attention中存在因果掩码的机制,也就是要让前面的token没办法看到后面token的得分,因此在计算得分矩阵结果时可以将上三角矩阵的元素丢掉不进行计算来节省资源,
对于tiling后的结果而言,结果中全部属于上三角的块直接丢弃不要,不进入循环,在对角线上的块正常进循环计算,然后再逐元素将块内上三角的元素丢弃。
2 Kernel 设计:grid、block、线程分工
写 kernel 前先想清楚谁干什么活:
grid.x = ceil(N/Br)    每个 block 负责一段 Q 行 [q_start, q_start+Br)
grid.y = B*H           合并索引,进 block 先算出自己处理哪个 (b,h) 切片
block  = Br 线程        线程号 = 块内行号,一线程一行

每个线程分配:
  1. 参与把 Q 块搬进 shared(协作搬运,之后再也不碰 HBM 的 Q)
  2. 清零自己那行的 Oacc,m_reg=-inf,l_reg=0
  3. 内循环 Tc 轮:算 S(自己行 × 整个 K 块)→ online softmax 合并 → 累加 Oacc
  4. 结束后 O = Oacc/l,写回自己那行——全程唯一一次 HBM 写
block 里的 warp 分工:Br=128 时 4 个 warp,每 warp 32 行。S 计算、softmax 更新、Oacc 累加全是行内的事,warp 之间零通信,只有搬 K/V 和双缓冲同步需要 __syncthreads()。
3 代码分析
3.1 动态 shared 布局
新增padding减少bank conflict:
extern __shared__ float smem[];
float* Ks   = smem;                                    // [2][Bc][D]  双缓冲
float* Vs   = Ks + 2 * Bc * HEAD_DIM;                  // [2][Bc][D]  双缓冲
float (*Qs)[HEAD_DIM + 1] =                             // [Br][D+1]   驻留整个内循环
    reinterpret_cast<float (*)[HEAD_DIM + 1]>(Vs + 2 * Bc * HEAD_DIM);
float (*Oacc)[HEAD_DIM + 1] =                           // [Br][D+1]   未归一化 Õ
    reinterpret_cast<float (*)[HEAD_DIM + 1]>(&Qs[Br][0]);
Qs 和 Oacc 那个 +1 padding 是消 bank conflict 的:一线程一行按行访问,行距 65 个 word,65 ≡ 1 (mod 32),相邻线程错开一个 bank。Ks/Vs 不 padding,因为计算时 warp 内 32 个线程读的是同一个 K 行(广播),广播不冲突。理论上sram这样的设计是conflict free的。
使用Tensor core的wmma命令时要注意padding后对齐fragment的16b数据的tile,避免命令调用错误,或者使用swizzle来避免bank conflict。
3.2 cp.async 异步搬运 + K/V 双缓冲
使用异步拷贝命令:
__device__ __forceinline__ void kv_async_copy_v2(
    const float* k, const float* v,
    float* Ks, float* Vs,
    size_t bh, int kv_start, int N, int buf)
{
    int tx = threadIdx.x;

    const float4* kg = reinterpret_cast<const float4*>(
        k + bh * N * HEAD_DIM + (size_t)kv_start * HEAD_DIM);
    const float4* vg = reinterpret_cast<const float4*>(
        v + bh * N * HEAD_DIM + (size_t)kv_start * HEAD_DIM);//指针寻址,按张量维度跳过相应个元素,寻到所要块的第一个元素指针地址
    float4* ks = reinterpret_cast<float4*>(Ks + (size_t)buf * Bc * HEAD_DIM);
    float4* vs = reinterpret_cast<float4*>(Vs + (size_t)buf * Bc * HEAD_DIM);//buf=0 时 ks 指向 buffer 0 起点,buf=1 时偏移 Bc*D 个 float 指向 buffer 1。前台算的是 buffer 0,后台 cp.async 落地的是 buffer 1,靠这个参数错开。


    constexpr int NVEC = Bc * HEAD_DIM / 4;//1块 K 有 Bc*D 个 float,按 16B(4 float)切就是 NVEC 个块。Bc=32、D=64 时 = 512 个 16B 块
    for (int i = tx; i < NVEC; i += blockDim.x) {
//线程跨步认领
        int  row = (i * 4) / HEAD_DIM;
        bool ok  = (kv_start + row) < N;
        __pipeline_memcpy_async(&ks[i], &kg[i], 16, ok ? 0 : 16);
        __pipeline_memcpy_async(&vs[i], &vg[i], 16, ok ? 0 : 16);
    }
}
将拷贝命令封装成一个函数调用。
外循环:
 // ---- Q 加载一次,驻留整个内循环 ----
    for (int idx = tx; idx < Br * HEAD_DIM; idx += blockDim.x) {
        int r = idx / HEAD_DIM, c = idx % HEAD_DIM;
        if (q_start + r < N)
            Qs[r][c] = q[base + (size_t)(q_start + r) * HEAD_DIM + c];
    }

    // ---- 每线程自己的状态:m/l 进寄存器(kernel 内初始化,无 HBM 往返)----
    float m_reg = -INFINITY;
    float l_reg = 0.0f;
    #pragma unroll
    for (int d = 0; d < HEAD_DIM; d++)
        Oacc[row][d] = 0.0f;      // Õ 清零

    __syncthreads();

    // ---- prologue:预取第 0 个 K/V 块 ----
    kv_async_copy_v2<Bc, HEAD_DIM>(k, v, Ks, Vs, bh, 0, N, 0);
    __pipeline_commit();
双缓冲操作:
v1  : [搬K0][算0][搬K1][算1][搬K2][算2]...      搬运时计算单元干瞪眼
v2  : [搬K0][算0 | 后台搬K1][算1 | 后台搬K2]...  HBM 延迟藏进上一块的计算里
内循环里的写法:
for (int j = 0; j < Tc; j++) {
    int cur = j & 1;                              // 本轮用哪个 buffer
    if (j + 1 < Tc) {
        kv_async_copy_v2(..., cur ^ 1);           // 预取 j+1 到另一个 buffer,立刻返回
        __pipeline_commit();
    }
    __pipeline_wait_prior(j + 1 < Tc ? 1 : 0);    // 等当前块到货(最后一轮要等全部)
    __syncthreads();                              // cp.async 只保证发起线程可见,同步后全 block 可见
    // ... 用 Ks[cur]/Vs[cur] 计算 ...
    __syncthreads();                              // 所有人读完 cur,下一轮预取才能覆盖它
}
- 越界行 zfill:末块的 K/V 可能不够 Bc 行,
__pipeline_memcpy_async的第 4 个参数传 16 表示「这 16B 不读源、直接填 0」。配合 S 计算时把越界 key 置 -inf,杜绝幻影权重(exp(-inf)=0)。 - 为什么
wait_prior(1)而不是wait_prior(0):刚发出的 j+1 预取还在飞,我们只需要 j 到货。等 0 的话预取就白发了,双缓冲退化成串行。 - 双缓冲的操作让两个warp同时读取sram时会发生少量bank conflict,ncu查看时conflict占百分之1.7左右并且存在浮动,目前不知道是由于硬件指令还是由于编译器引起。
3.3 内循环主体:S → P → 合并 → 累加
// 1. S = Qs[row] · Kj^T(自己那行打整个 K 块)
float S[Bc];
#pragma unroll
for (int c = 0; c < Bc; c++) {
    const float* krow = Kj + c * HEAD_DIM;
    float s = 0.0f;
    #pragma unroll
    for (int d = 0; d < HEAD_DIM; d++)
        s += Qs[row][d] * krow[d];
    S[c] = (kv_start + c < N) ? s * softmax_scale : -INFINITY;
}

// 2. 本块统计:m̃ / P / l̃
float m_tilde = -INFINITY;
#pragma unroll
for (int c = 0; c < Bc; c++)
    m_tilde = fmaxf(m_tilde, S[c]);

float P[Bc];                       // P 预存!v1 在 PV 里重复算 exp,这里修掉了
float l_tilde = 0.0f;
#pragma unroll
for (int c = 0; c < Bc; c++) {
    P[c] = __expf(S[c] - m_tilde);
    l_tilde += P[c];
}

// 3. 新旧合并(汇率换算到新基准 m_new)
float m_new     = fmaxf(m_reg, m_tilde);
float scale_old = __expf(m_reg - m_new);     // 历史 Õ 换基准
float scale_new = __expf(m_tilde - m_new);   // 本块 P̃V 换基准
l_reg = scale_old * l_reg + scale_new * l_tilde;
m_reg = m_new;

// 4. Õ 累加(延迟归一化:不除 l,纯乘加)
#pragma unroll
for (int d = 0; d < HEAD_DIM; d++) {
    float pv = 0.0f;
    #pragma unroll
    for (int c = 0; c < Bc; c++)
        pv += P[c] * Vj[c * HEAD_DIM + d];
    Oacc[row][d] = scale_old * Oacc[row][d] + scale_new * pv;
}
对比 v1 同位置的代码,三处变化:
- P 预存。v1 的 PV 内积里
exp(S[c]-m̃)写在内层 d 循环里,理论上要算 Bc×D 次,实际不同的只有 Bc 次。v2 先把 P 数组算好存着,PV 里纯查表。 - Oacc 无除法。v1 是
(scale_old * Os + scale_new * pv) / l_new,每轮 D 次除法;v2 只有乘加,除法推迟到最后。 - m/l 是寄存器。v1 这三步之前还要先从 HBM 读回 m_reg/l_reg/Os,算完再写回去;v2 的 m_reg/l_reg 就是两个寄存器,Oacc 在 shared,全程零 HBM。
S[Bc] 和 P[Bc] 这两个局部数组靠 #pragma unroll 进了寄存器(SASS 里零条 LDL/STL,栈帧 0B),这是数组下标全是编译期常量的红利,上一篇讲 SROA 时验证过。
3.4 Causal mask:两级粒度
v2 的 Q 外层结构给 causal 留了一个天然优势:块级跳过。
第 grow 行能看到的 key 编号最大是 grow。本 Q 块里最大的行号是 q_start+Br-1,所以根本不用碰起点在 q_start+Br 之后的任何 K/V 块——直接把内循环的终点砍掉:
const int kv_limit = CAUSAL ? min(q_start + Br, N) : N;
const int Tc = (kv_limit + Bc - 1) / Bc;   // 对角线以上的块根本不进循环
比如 N=2048、Br=128、qb=5 时本块行号 [640,768),只处理 key < 768 的块,768 之后的 40 个块直接消失,一行 if 都不用。光这一下就砍掉接近一半的计算量(实测 ~1.7× 加速)。
砍剩下的块里大部分是「整块可见」的(块内最大 key 编号 ≤ q_start),完全不用 mask;只有斜跨对角线的那一块需要逐元素判断:
const bool diag_block = CAUSAL && (kv_start + Bc - 1 > q_start);

// S 计算的循环里:
if (diag_block && kv_start + c > grow)    // 注意是 grow(行级)不是 q_start(块级)
    S[c] = -INFINITY;
-inf 过 exp 后变 0,softmax 权重自然为零,不用特殊处理。
3.5 收尾 写回
if (row_valid) {                    // 末块可能越界,越界线程不写
    float inv_l = 1.0f / l_reg;     // 倒数:D 次除法变 1 次除法 + D 次乘法
    #pragma unroll
    for (int d = 0; d < HEAD_DIM; d++)
        o[base + (size_t)grow * HEAD_DIM + d] = Oacc[row][d] * inv_l;
}
O 全程唯一一次 HBM 写就发生在这里。对比 v1:每个外层块都要把全部 O 读回来再写回去——v2 的 IO 大头就是这么消失的。
4 性能
4.1 各版本对比
N=8192、B=4、H=8、D=64、FP32,cudaEvent 计时:
版本              结构                     耗时       TFLOPS
v1   (Br=32)     KV外层, grid=B×H         3194 ms    0.17
v1   (Br=48)     KV外层, 静态shared上限    2095 ms    0.26
v1.1 (Br=64)     + cp.async 双缓冲         1378.8 ms  0.40
v2   (Br=128)    Q外层, 全部重写             38 ms    14.45   ← 26% FP32 峰值
v2 causal        + 块级跳过                 21.4 ms    12.87
v1.1 到 v2 的 36 倍不是某个单点优化,是结构重写的总账:循环换边解放了 block 数(32 → 2048),状态片上化干掉了 O 的 64 次 HBM 往返,延迟归一化和 P 预存削了指令,Br=128 靠动态 shared 解锁。
4.2 剩下的瓶颈在哪:ncu + SASS 对账
26% 的峰值利用率到底卡在哪?用 ncu 和 SASS 分析:
bank conflict。 理论零冲突,ncu 实测有 18 万次 ld conflicts。但这不是真的模式冲突:一是两次运行数值在漂(186,145 vs 178,616),模式性冲突是确定性的不该漂;二是 wavefront 计数(71,543,336 vs 71,543,907,差百万分之八)。结论:冲突来自跨 warp 的运行时碰撞——后台飞的 LDGSTS(cp.async 写 buffer 1)和正在执行的 LDS(读 buffer 0)同周期撞 bank,双缓冲的固有噪声,占比 0.26%。
真瓶颈是延迟隐藏,不是吞吐。 从指令数对账:每 warp 每轮 j 迭代约 4468 条 FMA 管线指令、1305 条 LSU 指令(实测对模型误差 1% 以内),LSU 按条数看只有 FMA 的 0.29 倍,shared 吞吐不是障碍。但 97KB 的 shared 把每 SM 锁死在 1 个 block——4 个 warp,恰好每个 SMSP 只驻 1 个 warp。LDS 一来就是 ~30 周期延迟,手里没有第二个 warp 可以切换,SMSP 只能干等。从总时长反推:发射口占用 ~36%,FFMA 占用 ~28%,对上实测的 26%。
Br=128 97KB(1 block/SM),Br=32 能驻 2 个 block 但 warp 摊不满 4 个 SMSP。根源是「一线程一行」的标量布局太吃 shared——Oacc+Qs 占了 66KB。
4.3 和官方 FA2 的对比:
拷打ai后得到这样的一张对比表:
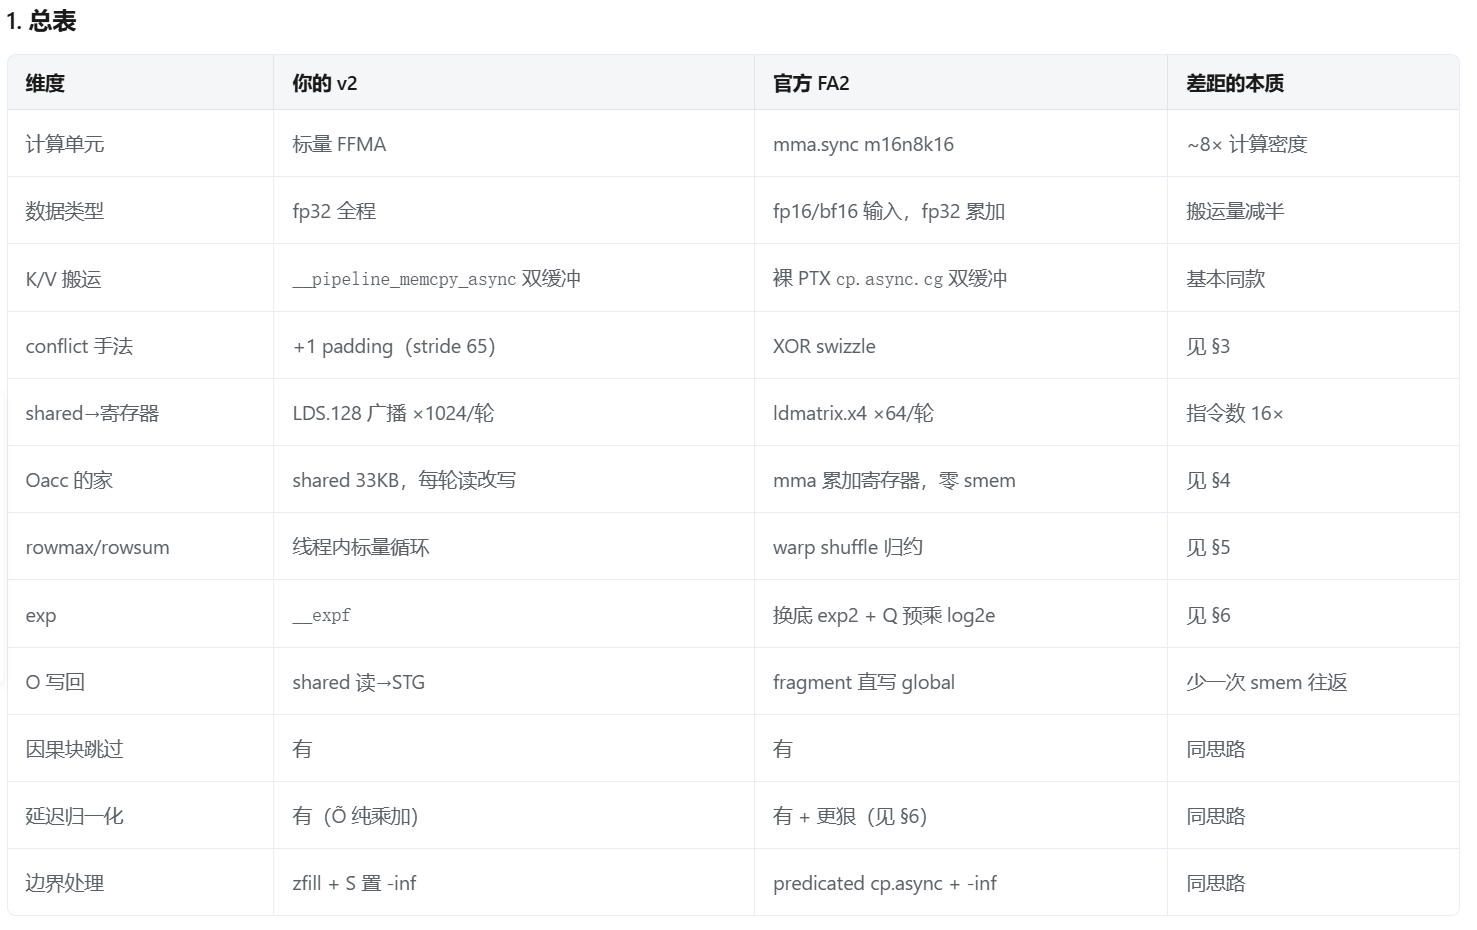
这些优化将在下个版本v2.1中重构代码实现。
5 总结
v2 相对 v1 的全部改动:
- 循环换边(Q 外层、K/V 内层):grid 从恒定 32 个 block 变成随 N 增长,占用率问题从结构上消失——这是最大的一笔
- 状态片上化:Q 驻留 shared、m/l 进寄存器、O 变 shared 累加器,HBM 往返从 2N²D/Bc 掉到 2ND
- 延迟归一化:内循环零除法,最后除一次
- cp.async 双缓冲(v1.1 引入,v2 平移):HBM 搬运延迟藏进计算
- causal 两级 mask:块级跳过砍一半计算量(~1.7×),只有跨对角线块做逐元素判断
- P 预存 + 动态 shared 解锁 99KB:指令削减和 Br=128
还没做的:Tensor Core(mma.sync + ldmatrix + fragment 布局)。
参考:
FlashAttention-2 论文 (2307.08691)